Research in generative visual intelligence生成式视觉智能研究

Lifan Jiang (姜利范)

lifanjiang@zju.edu.cn

Ph.D. Student · Zhejiang University浙江大学 · 博士研究生

College of Computer Science and Technology计算机科学与技术学院

I am a Ph.D. student at the College of Computer Science and Technology, Zhejiang University, where I started my doctoral studies in 2025. My research focuses on diffusion models, world models, and controllable image and video generation.我于 2025 年开始在浙江大学计算机科学与技术学院攻读博士学位。我的研究聚焦于扩散模型、世界模型,以及可控图像与视频生成。

I work on efficient, structure-preserving image editing, identity-consistent video customization, and persistent geometric worlds for video generation. My industry research experience includes Ant Group and Darwin Intelligence.我关注高效且保持结构的图像编辑、身份一致的视频定制,以及面向视频生成的持久几何世界构建。我曾在蚂蚁集团和达迩文开展研究与项目工作。

Diffusion Models扩散模型World Models世界模型Image & Video Generation图像与视频生成
Portrait of Lifan Jiang
Hangzhou, China中国 · 杭州

Publications论文

Selected research代表性研究

* Equal contribution* 表示共同第一作者

  1. ACM MM 2026CCF-AAccepted已录用

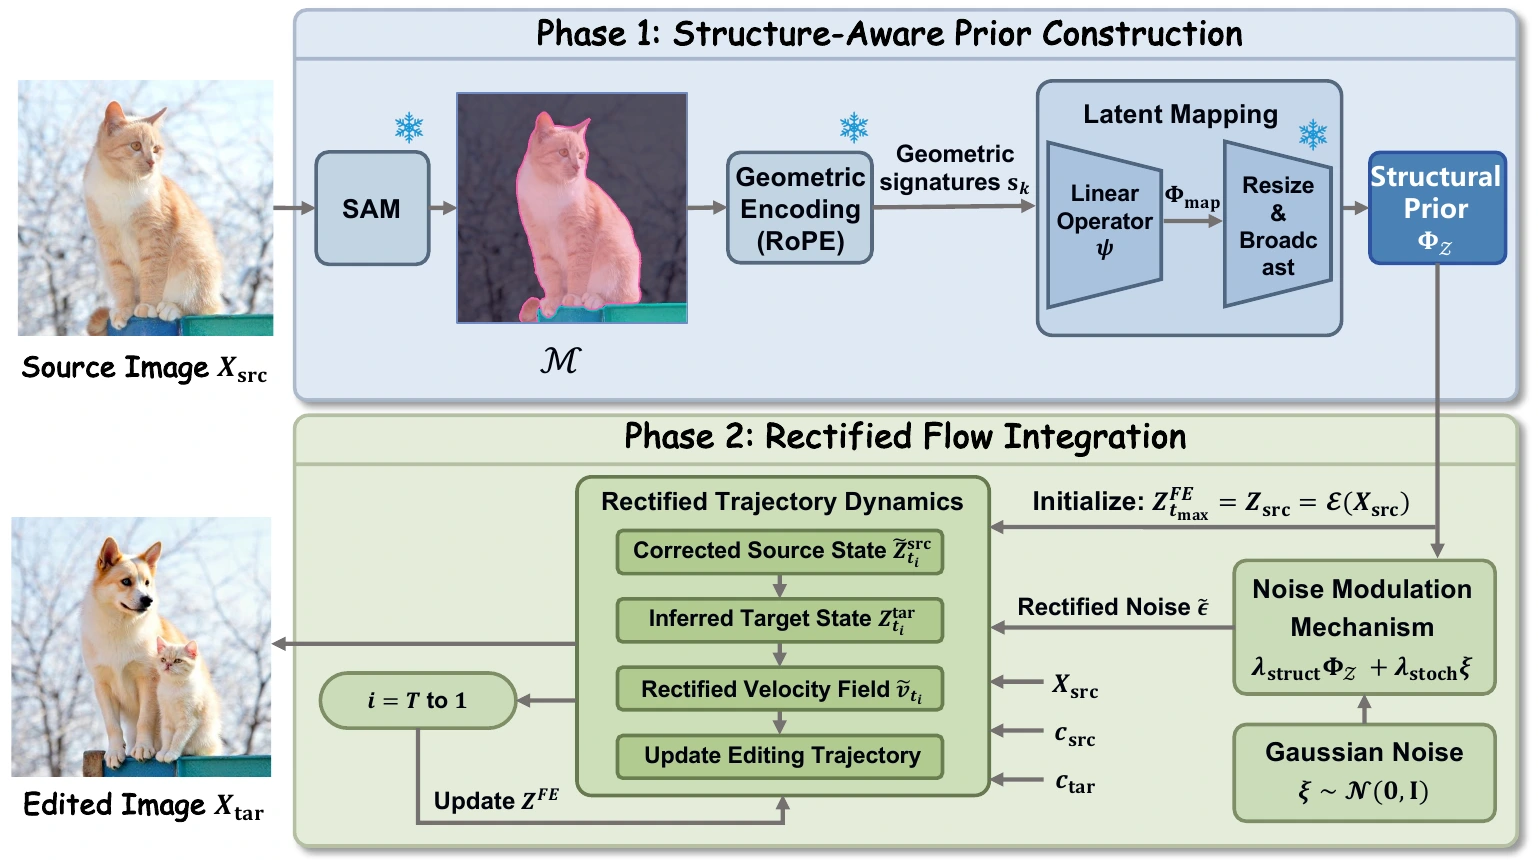
    SNR-Edit: Structure-Aware Noise Rectification for Inversion-Free Flow-Based Editing

    Lifan Jiang, Boxi Wu, Yuhang Pei, Tianrun Wu, Yongyuan Chen, Yan Zhao, Shiyu Yu, Deng Cai

    Structure-aware noise rectification anchors generative flows for training-free image editing while preserving the original spatial layout.通过结构感知噪声校正,为无需训练、无需反演的图像编辑提供几何约束,保持原图空间布局。

    Method pipeline · Figure 3 from SNR-Edit: Structure-Aware Noise Rectification for Inversion-Free Flow-Based Editing
    Method pipeline · Figure 3方法流程图 · 图 3
  2. ICCV 2025CCF-APublished已发表

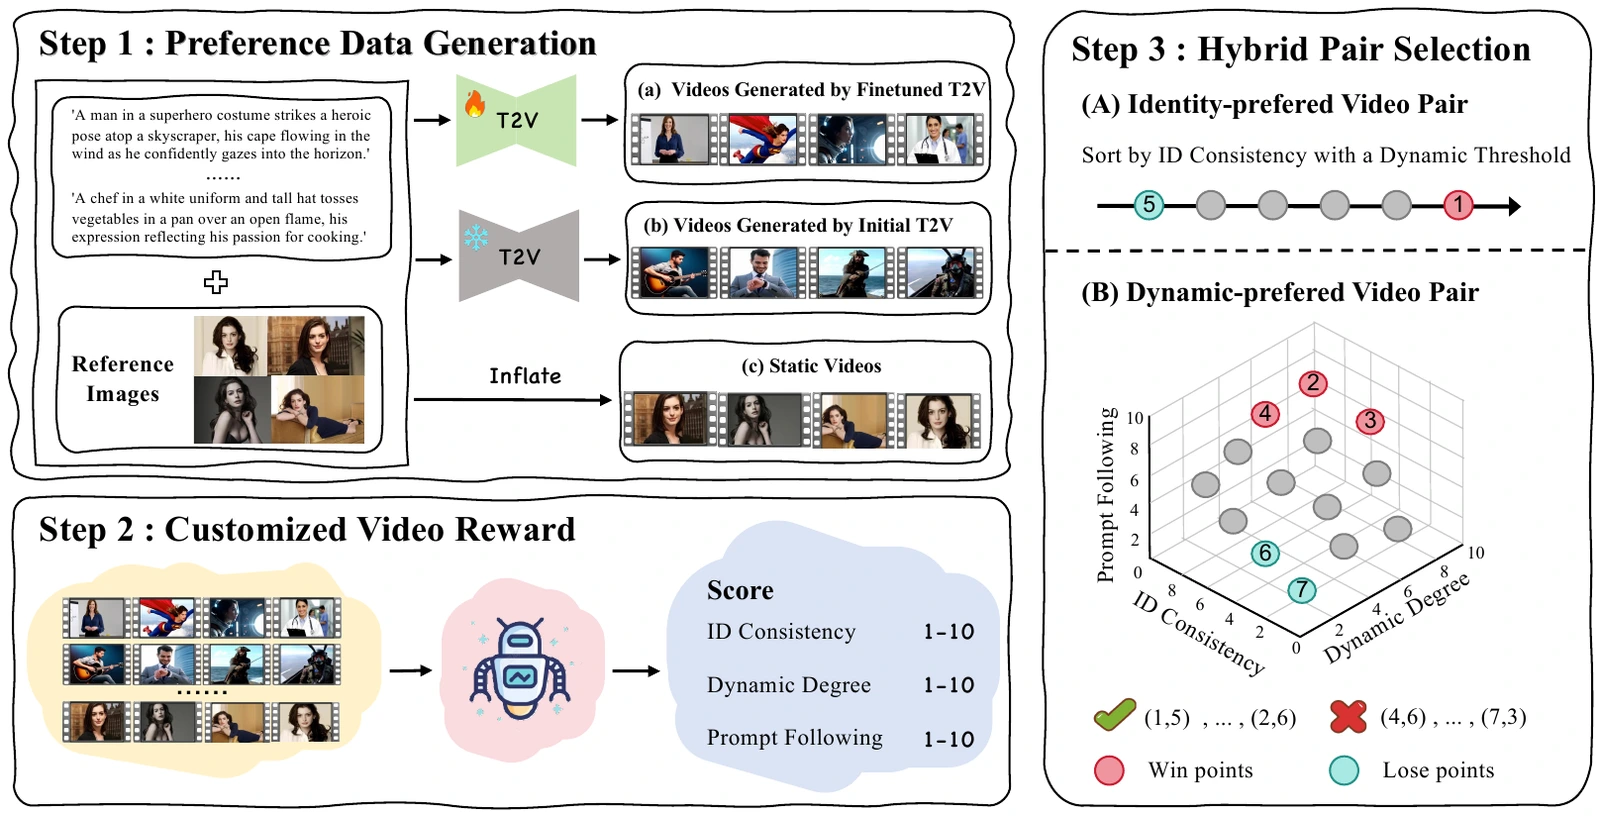
    MagicID: Hybrid Preference Optimization for ID-Consistent and Dynamic-Preserved Video Customization

    Hengjia Li*, Lifan Jiang*, Xi Xiao*, Tianyang Wang, Hongwei Yi, Boxi Wu, Deng Cai

    Hybrid preference optimization preserves subject identity and natural motion in personalized video generation.利用混合偏好优化,在个性化视频生成中兼顾人物身份一致性与自然运动。

    Preference construction · Figure 3 from MagicID: Hybrid Preference Optimization for ID-Consistent and Dynamic-Preserved Video Customization
    Preference construction · Figure 3偏好数据构建流程 · 图 3
  3. Neural Networks 2026JCR Q1Published已发表

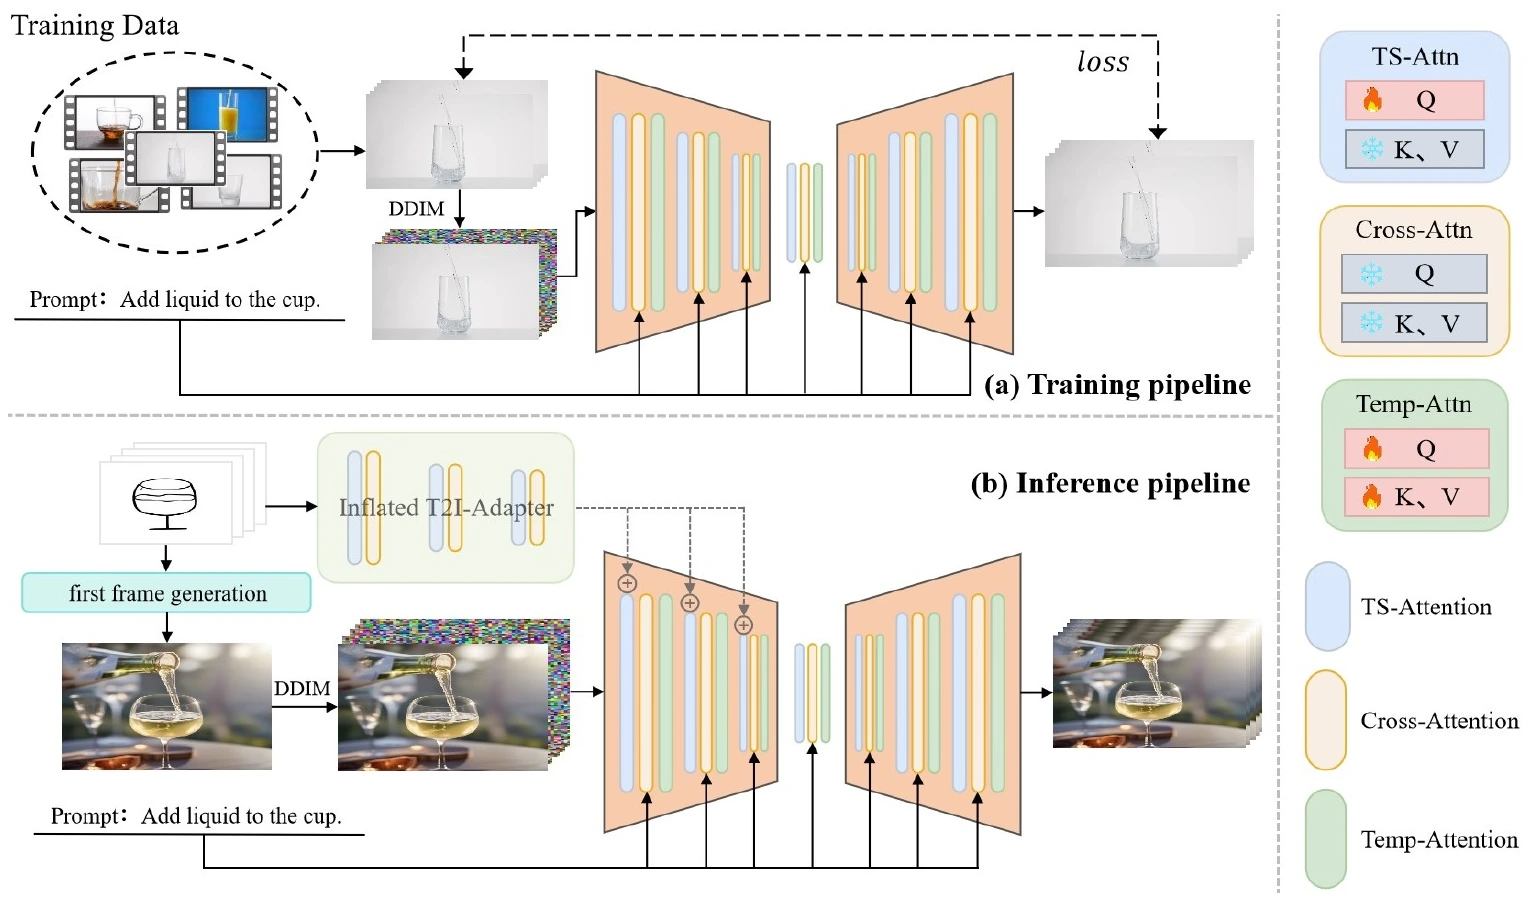
    VidSketch: Hand-drawn Sketch-Driven Video Generation with Diffusion Control

    Lifan Jiang*, Shuang Chen*, Boxi Wu, Xiaotong Guan, Jiahui Zhang

    Sketch-guided diffusion turns sparse hand-drawn sketches and text into coherent videos, with guidance adapted to drawing abstraction levels.将稀疏手绘草图和文本转化为连贯视频,并根据草图抽象程度自适应调整生成引导。

    Training & inference · Figure 3 from VidSketch: Hand-drawn Sketch-Driven Video Generation with Diffusion Control
    Training & inference · Figure 3训练与推理流程 · 图 3
  4. Pattern Recognition 2026JCR Q1Published已发表

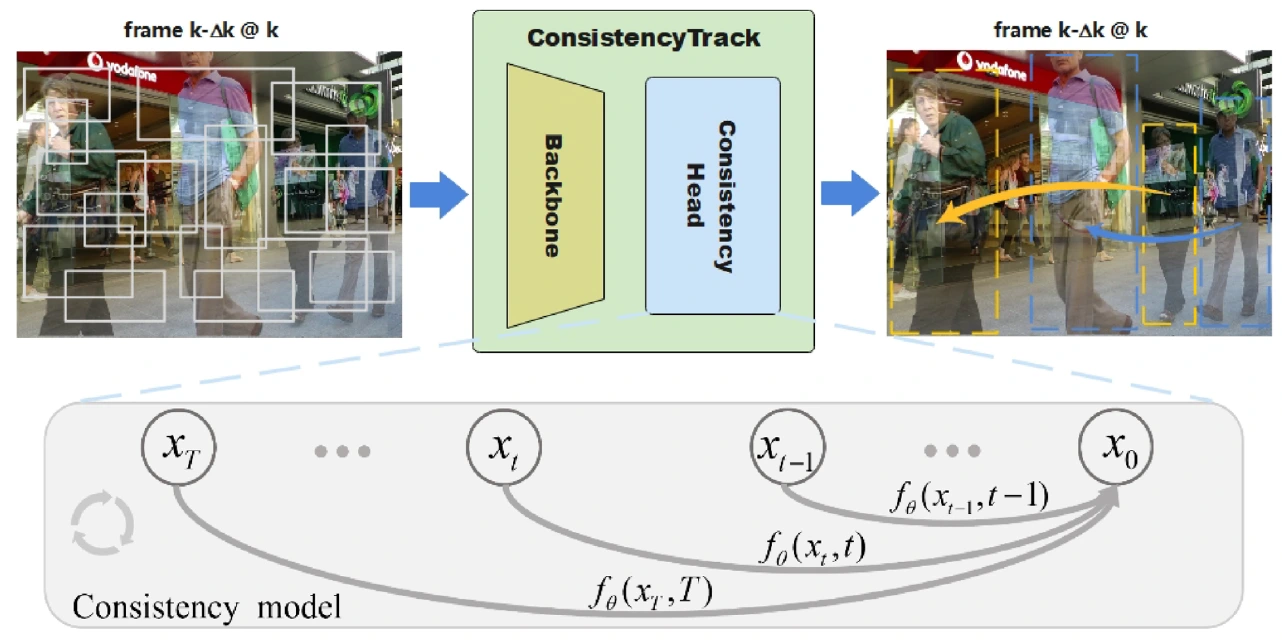
    ConsistencyTrack: A Robust Multi-Object Tracker with a Generation Strategy of Consistency Model

    Lifan Jiang, Zhihui Wang, Siqi Yin, Guangxiao Ma, Peng Zhang, Boxi Wu

    Consistency-model denoising unifies detection and association for robust, efficient multi-object tracking.以一致性模型去噪统一目标检测与关联,实现鲁棒、高效的多目标跟踪。

    Figure from ConsistencyTrack: A Robust Multi-Object Tracker with a Generation Strategy of Consistency Model
  5. ICLR 2027Under review投稿中

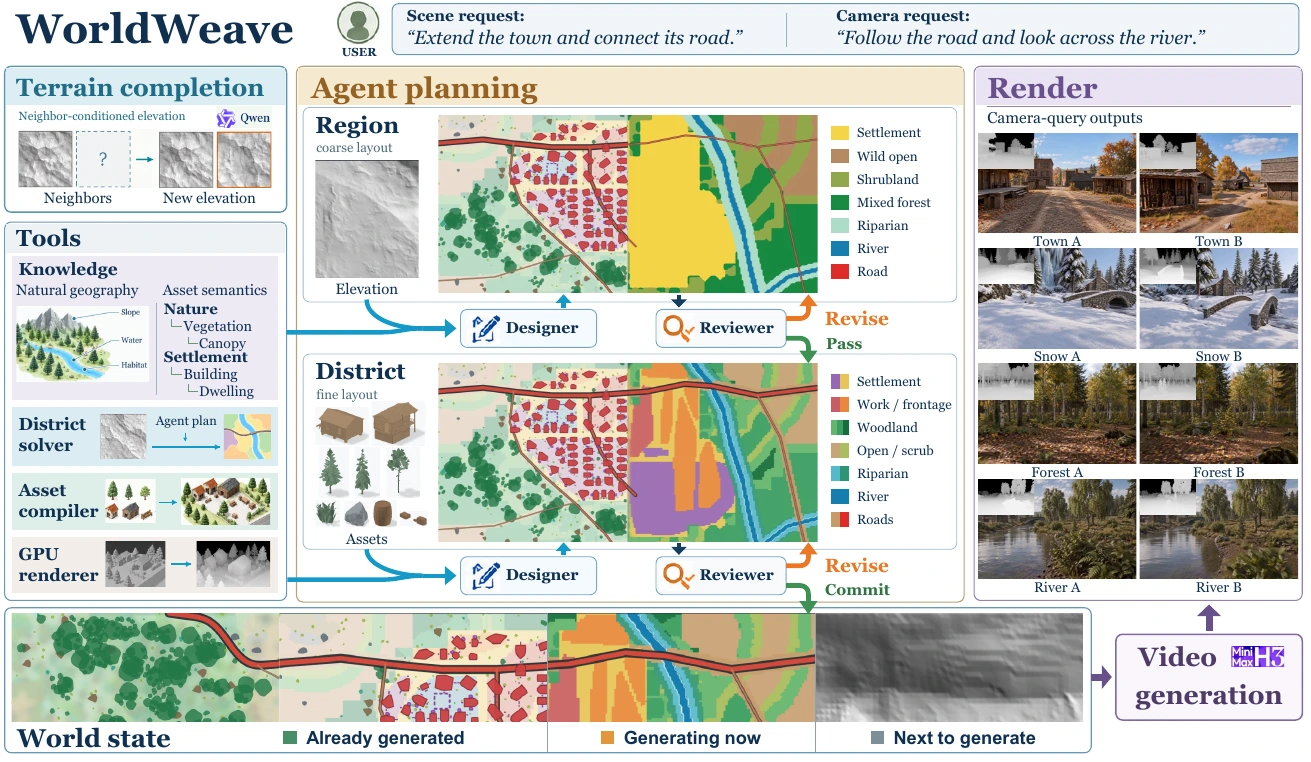
    WorldWeave: Growing Persistent Geometric Worlds for Video Generation

    Yifan Huang, Lifan Jiang, Qingyue Hao, Cheng Chen, Boxi Wu, Xiaoxue Ren, Xiaofei He, Dehai Zhao

    An expandable 3D world combines diffusion-based terrain completion and agent-guided planning, preserving geometric memory across camera trajectories and revisits.结合扩散式地形补全与智能体规划构建可扩展三维世界,在不同相机轨迹与重复访问中保持几何记忆。

    Figure from WorldWeave: Growing Persistent Geometric Worlds for Video Generation
  6. ICLR 2027Under review投稿中

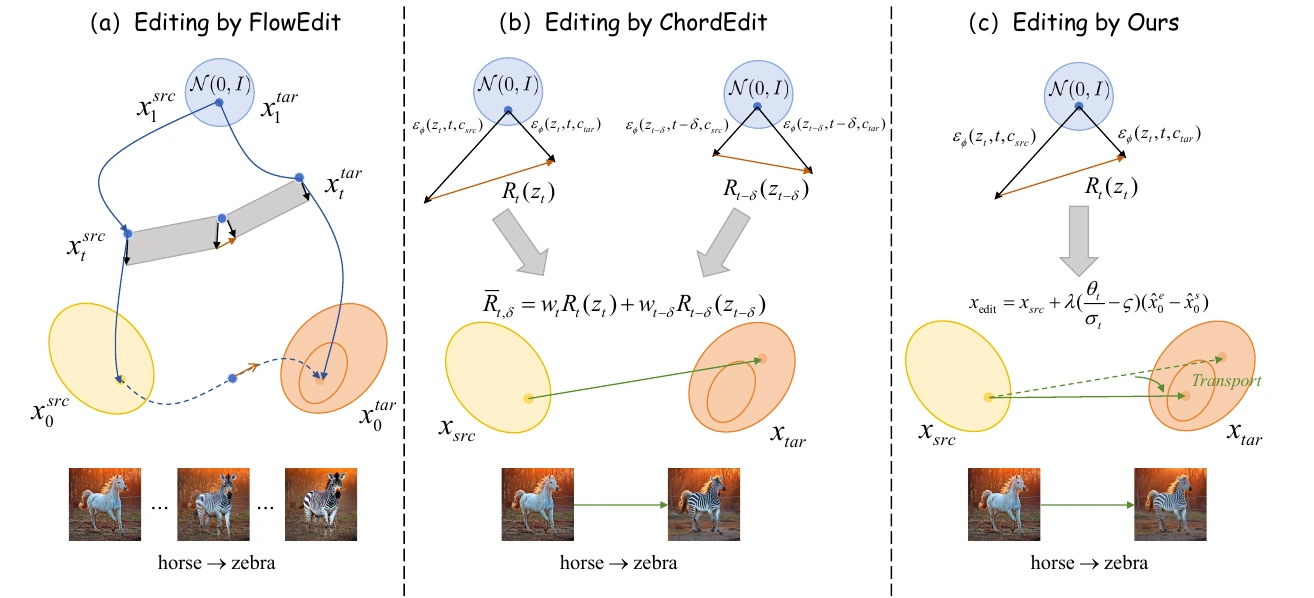
    One Evaluation Is Enough: Inversion-Free Image Editing with Trajectory Correction

    Lifan Jiang, Taiyang Chen, Senlin cheng, Bolei Xu, XIAOBO LI, Can Ye, Dehai Zhao, Deng Cai, Boxi Wu

    Endpoint-Calibrated Transport enables training-free, inversion-free editing with one noise level, one batched denoiser evaluation, and one latent update.端点校准传输仅用一个噪声水平、一次批量去噪评估和一次潜变量更新,实现无需训练与反演的图像编辑。

    Editing dynamics · Figure 2 from One Evaluation Is Enough: Inversion-Free Image Editing with Trajectory Correction
    Editing dynamics · Figure 2编辑原理图 · 图 2

Projects & Experience项目与经历

From research to systems从研究到系统实现

Darwin Intelligence达迩文

Nov 2025–Mar 2026 · Aug 2026–Present2025.11–2026.03 · 2026.08–至今

Research Intern & Primary Project Lead研究实习生 / 项目主要负责人

Persistent worlds for generative video面向生成式视频的持久世界构建

Led the World Model Team's development of WorldWeave: diffusion-based terrain outpainting, agent-guided hierarchical planning, geometry compilation, and camera queries. The framework supports continual scene expansion while preserving previously committed world structure.负责世界模型团队的 WorldWeave 框架研发,结合扩散式地形外绘、智能体分层规划、几何编译与相机查询,支持持续扩展场景并保留已构建的世界结构。

World models3D geometryVideo generation

Ant Group蚂蚁集团

Apr–Aug 20262026.04–2026.08

Research Intern · Alipay Content Generation Team研究实习生 · 支付宝内容生成团队

Digital humans & efficient audio-video generation电商数字人与高效音视频生成

Researched e-commerce digital-human generation. Developed DualCast with product and presenter image conditioning, and CAVC, a training-free audio-visual caching strategy that accelerates generation while maintaining audio quality and cross-modal alignment.开展电商数字人生成研究:研发以商品与人物图像为条件的 DualCast,以及无需训练的音视频缓存策略 CAVC,在保持音频质量与跨模态对齐的同时提升生成效率。

Digital humansDiffusion TransformersAudio-video generation

Education教育经历

Honors & Awards荣誉与奖励

Figure from the original paper截图来自论文原图